Jev llegó y no quiere hablar contigo: la IA que solo decide
TypeSafe AI salió del stealth con Jev, un modelo que no genera texto, no alucina y responde en milisegundos. La promesa: inteligencia de frontera para software, no para chat. Y el mercado ya está mirando.
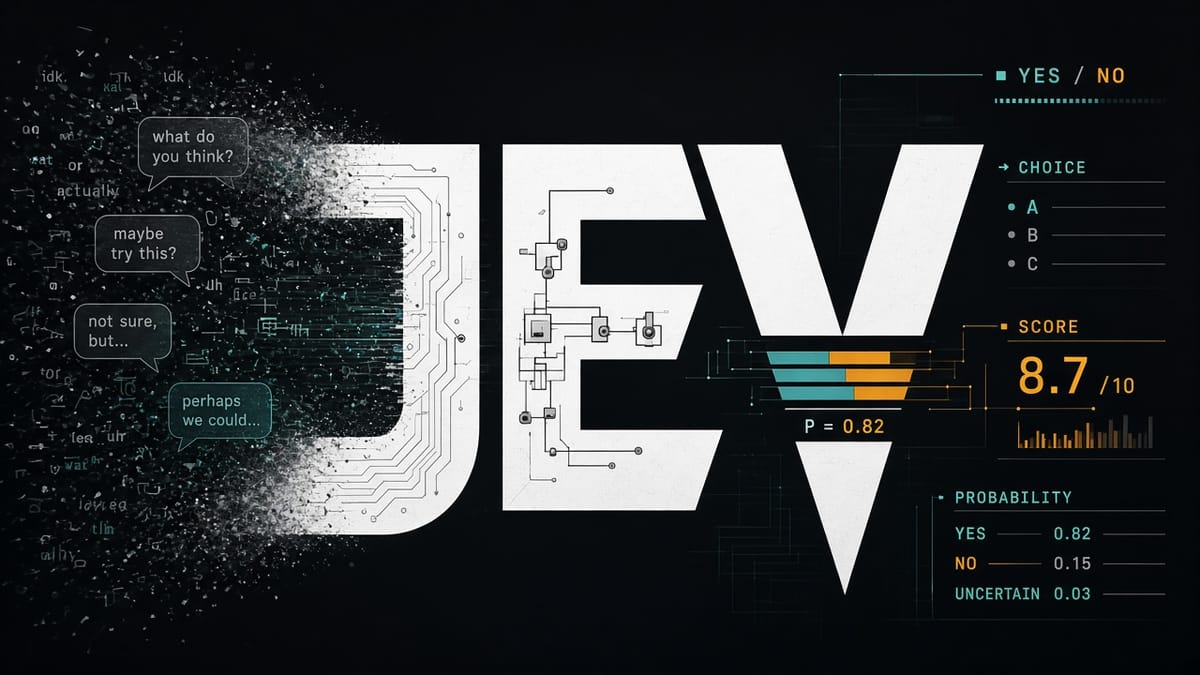
El 15 de septiembre de 2026, TypeSafe AI salió del stealth con un anuncio raro en una industria obsesionada con chatbots: lanzó Jev, un modelo que no puede hablar.
No escribe párrafos. No redacta emails. No genera código. No inventa JSON a medias.
Recibe el estado de tu sistema, recibe preguntas tipadas… y responde con decisiones: sí/no, opciones, puntajes. Cada una con probabilidad y confianza.
En simple: no es un ChatGPT más barato. Es otra categoría.
Y por eso está en boca de todos.
Qué es Jev (sin el marketing)
Jev es el primer System One Model público de TypeSafe AI, una startup fundada por Diogo Almeida, investigador que trabajó en OpenAI en los métodos detrás de ChatGPT y el RLHF.
La tesis de Almeida es provocadora: si los modelos ya son casi sobrehumanos conversando… ¿dónde está toda la automatización?
Su respuesta: el chat no es la interfaz correcta para software. Un LLM genera tokens uno por uno, después hay que parsear, validar, reintentar cuando alucina, y pagar por cada palabra que inventó. Eso sirve para humanos. Para producción a escala, es un cuello de botella.
Jev hace lo contrario:
- Entrada: estado no estructurado (texto, JSON, datos del programa)
- Preguntas: Choice (elige), Score (puntúa), Noul (sí/no)
- Salida: valores tipados + probabilidades calibradas
- Sin generación de strings
TypeSafe lo describe como una function call con inteligencia de frontera: entra estado, salen decisiones.
Por qué el nombre suena a teoría económica (y a Kahneman)
Hay dos referencias metidas en el branding:
- System One viene de Daniel Kahneman (Thinking, Fast and Slow): el Sistema 1 es pensamiento rápido e intuitivo; el Sistema 2 es lento y deliberado. Jev quiere ser el Sistema 1 del software. Los LLM grandes serían más Sistema 2: razonar, escribir, explorar.
- Jev viene de William Stanley Jevons, el economista detrás de la paradoja de Jevons: cuando el carbón se usó de forma más eficiente, la demanda no bajó… subió. TypeSafe apuesta a lo mismo con la inteligencia: si baja el costo por orden de magnitud, no usamos menos IA. Usamos mucho más.
Esa es la apuesta comercial. No reemplazar a Claude ni a GPT. Multiplicar las decisiones que hoy nadie automatiza porque son caras o lentas.
Los números que están haciendo ruido
Según TypeSafe:
| LLMs frontera | Jev | |
|---|---|---|
Precio input | $0.20 – $10 / MTok | $0.042 / MTok |
Precio output | ~5× el input | Gratis |
Latencia | 3 – 329 segundos | 70 – 500 ms |
Errores de tipo | existen | 0% (por diseño) |
Alucinaciones de string | posibles | imposibles (no genera texto) |
En sus propios workflow evals, llegan a hablar de hasta ~200× más rápido y ~400× más barato en el extremo alto.
Importante: gran parte de eso viene de benchmarks propios. Tests independientes (WotAI, AYAutomate) muestran algo más sobrio y útil:
- Jev es muy rápido y muy barato
- En accuracy, está más cerca de modelos chicos/rápidos que de los frontier top
- Su superpoder real no es “ser más inteligente que GPT-6”, sino decir cuándo no está seguro y permitir cascadas baratas: Jev decide lo fácil; un LLM caro entra solo cuando hace falta
Eso, para producción, puede importar más que ganar un leaderboard.
Para qué sirve de verdad
Casos de uso que ya están circulando:
1. Routing de tickets / emails / mensajes
¿Es urgente? ¿Es spam? ¿Va a soporte, ventas o legal? ¿Pide refund?
2. Guardrails de agentes
Antes de que un agent ejecute bash, borre algo o mande plata: ¿esta acción es riesgosa? LangChain ya publicó middleware con Jev para esto.
3. Model routing
¿Esta query necesita un modelo barato o uno caro? Jev elige. Ahorras plata sin degradar calidad cuando sí importa.
4. Scoring y verificación
Detectar jailbreaks, puntuar calidad de respuestas, clasificar logs, filtrar ruido en pipelines.
5. Tiempo real
Si respondes en 100–500 ms, la IA deja de ser “llamo a un chatbot y espero” y pasa a ser parte del loop de la app.
También hay demos más frikis: un bot de Doom reactivo y Wikiracing eligiendo entre cientos de links sin alucinar URLs. El mensaje es claro: esto vive dentro del código.
Por qué duele a los labs frontier
Porque toca el nervio del momento: el costo de la IA.
Durante meses la industria vivió en modo tokenmaxxing: más tokens, más reasoning, más agentes, más platita quemada. Ahora empresas están mirando la factura. Y aparece un modelo que dice: “para decidir, no necesitas un ensayo de 2.000 tokens”.
Eso no mata a OpenAI ni Anthropic. Pero sí pone presión al premium de precio en tareas que, honestamente, eran clasificación disfrazada de chat.
Si una parte grande del uso enterprise es:
- clasificar
- enrutar
- filtrar
- puntuar
- aprobar/rechazar
…entonces pagar un frontier model completo por cada microdecisión empieza a verse absurdo.
Lo que Jev NO es (y hay que decirlo)
No es AGI.
No reemplaza a Cursor.
No escribe tu PR.
No razona en abierto como un modelo con chain-of-thought largo.
Si le pides que te explique un bug, se queda mudo: no genera texto.
El diseño es deliberado. TypeSafe “renunció” a las strings para ganar velocidad, costo, tipado y calibración. Es un trade-off. Y por eso el framing correcto no es “Jev vs Claude”, sino:
LLM para generar y razonar. Jev para decidir dentro del software.
El detalle técnico que más importa a developers
Tres cosas que hacen distinto el stack:
- Arquitectura + sampler paralelo: responde todas las preguntas de una request a la vez. Agregar preguntas casi no suma latencia.
- RLCD (Reinforcement Learning for Calibrated Decisions): no optimiza “lo que un humano preferiría leer”, sino decisiones con incertidumbre honesta.
- Espacio de salida fijo: si las opciones son A/B/C, no puede inventar D. Eso elimina una clase entera de fallas que hoy rompen agentes en producción.
En Vercel AI Gateway y LangChain ya hay integraciones. La adopción temprana está siendo rápida precisamente porque el API se siente como software, no como un chat.
La lectura grande: estamos entrando a la era de la IA especializada
Primero llegaron los modelos generales que hablaban de todo.
Después los reasoning models que “piensan” más lento y mejor.
Ahora aparece otra capa: modelos que no te conversan, pero sí te permiten automatizar a escala.
Eso encaja con una idea que se viene repitiendo en 2026: la IA no va a ser un solo dios monolítico. Va a ser un stack.
- Un modelo genera
- Otro verifica
- Otro rutea
- Otro decide en 100 ms
- El código orquesta
Jev no inventó esa idea. Pero la empujó al mainstream con un producto concreto, un precio agresivo y un fundador con pedigree de OpenAI.
Jev no quiere ser tu nuevo chatbot favorito.
Quiere ser el if inteligente que tu software siempre necesitó y que hasta ahora resolvías con prompts frágiles, JSON roto y facturas infladas.
¿Va a cumplir todas las promesas de 200× y 400× en el mundo real? Todavía hay que medirlo fuera del marketing.
Pero el concepto ya quedó plantado: no toda la inteligencia artificial tiene que hablar.
A veces, alcanza con que decida bien, barato y a tiempo.